Attention Is All You Need
论文精读与 Transformer 架构详解
本讲义配套 B 站视频《Attention is all you need 论文解读及 Transformer 架构详细介绍》, 按视频的 9 个章节顺序组织,完整保留原视频的讲解逻辑与 PPT 素材,并对论文中所有关键公式 做了逐步推导。所有图表均取自原视频配套课件与论文原文。
00导读:这条主线该怎么读
Why Self-Attention — 一句话概括全片
视频给了一条非常清晰的主线,整部片子其实在反复回答一个问题: 为什么 Transformer 能带来革命性突破? 拆开来看是两个环节的因果链:
- 铺垫(第 1–5 章):依次引入 FNN → RNN → 编码器-解码器 → 注意力机制, 每一步都指出「它解决了什么,又留下了什么问题」。这是论文第 1、2 节 Introduction & Background 的完整展开。
- 收网(第 6 章):把并行化这条研究线索摊开——CNN 方案(Extended Neural GPU / ByteNet / ConvS2S)和 Memory Network 方案为什么都不彻底,从而反衬出 Transformer 的必要性。
- 主体(第 7 章):Transformer 架构逐层拆解,对应论文第 3、4 节 Model Architecture & Why Self-Attention,也是视频中占比最长、 信息密度最高的部分(约 33 分钟)。
视频章节索引
下表是原视频的章节时间轴,可用于对照跳转:
| 时间 | 章节 | 对应讲义 | 核心问题 |
|---|---|---|---|
| 00:00 – 02:02 | 简介 | §0 | 本片讲什么、怎么讲 |
| 02:02 – 04:35 | 摘要 | §0 / §1 | 什么是序列转导模型 |
| 04:35 – 07:05 | FNN | §2 | 为什么全连接不适合变长序列 |
| 07:05 – 10:07 | RNN | §3 | 递归计算的串行代价 |
| 10:07 – 12:31 | 编码器解码器 | §4 | 上下文向量 C 的信息瓶颈 |
| 12:31 – 15:41 | 注意力机制 | §5 | 长距离依赖与「重要性」加权 |
| 15:41 – 18:11 | 背景和研究 | §6 | CNN / Memory Network 为何不够 |
| 18:11 – 51:34 | Transformer | §7 | 架构逐层拆解(本片核心) |
| 51:34 – 52:32 | 结尾 | §8 | 三种注意力范式的对比与展望 |
01序列转导模型:任务的定义
Sequence Transduction Model — 一切工作的起点
1.1 什么是「序列」
序列数据是具有顺序关系的数据,每个元素的顺序对数据的整体含义都非常重要。 句子、语音、基因、时序信号都是典型的序列。
1.2 什么是「序列转导」
序列转导模型(Sequence Transduction Model)就是处理序列数据的模型: 输入一个变长序列,输出另一个变长序列。它的典型任务包括:
| 任务 | 输入 → 输出 |
|---|---|
| 文本翻译 | "How are you" → "你好吗?" |
| 文本生成 | "How are you?" → "I'm fine, thank you." |
| 语音识别 | 一个音频片段 → 对应的文字转写 |
02FNN:最朴素的方案为何失效
Feedforward Neural Network — 一切矛盾的原点
2.1 前馈神经网络的基本形态
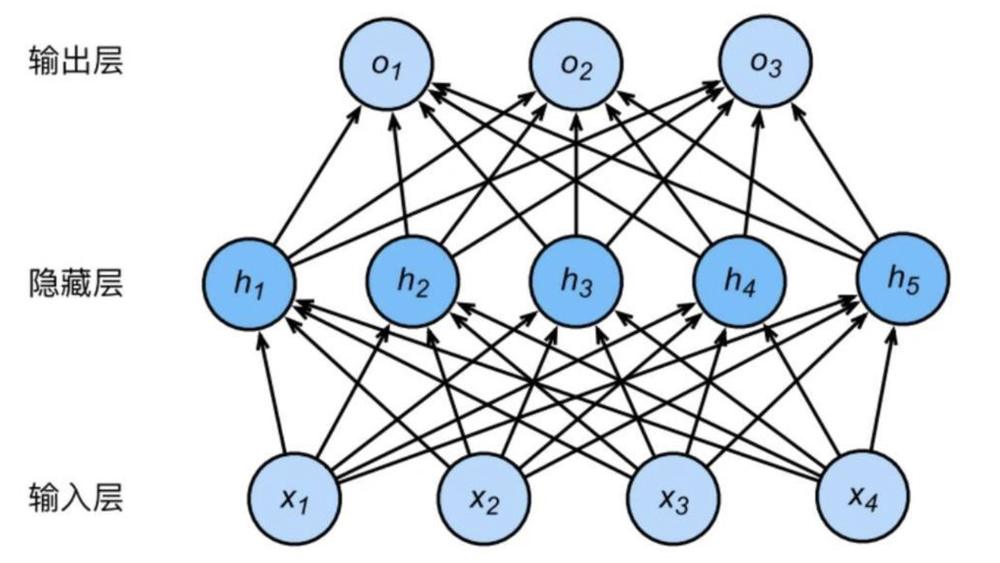
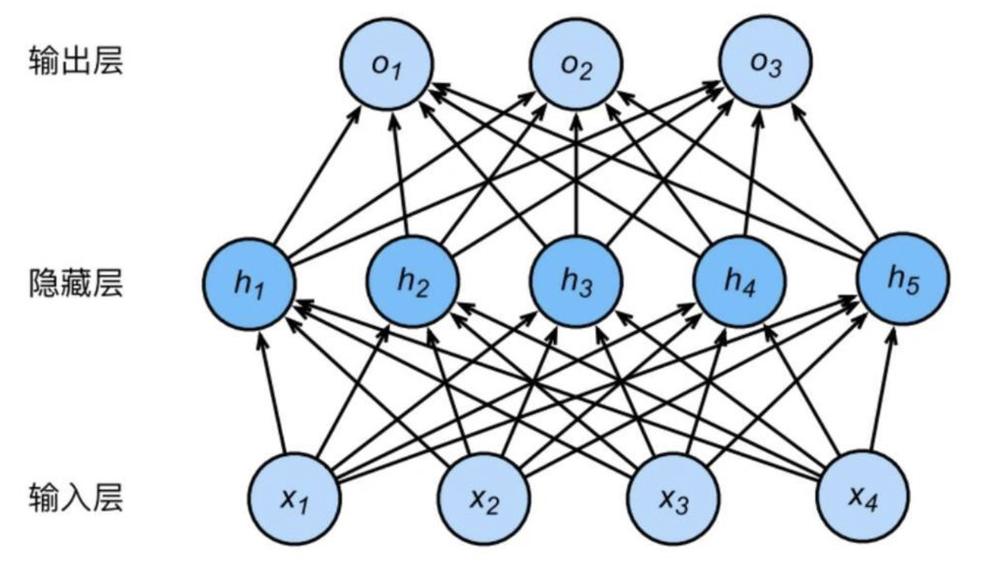
FNN(也叫 MLP,多层感知机)是深度学习的起点。它的结构非常直白:输入层进去, 经过若干隐藏层非线性变换,输出层出来。层与层之间是全连接的。
2.2 把 FNN 用来处理一句话:三步走
以「水是有毒的」这句话为例,走一遍标准的 NLP 前处理流程:
步骤一:分词(Tokenization)
["水", "是", "有毒", "的"]步骤二:词向量表示(Embedding)
每个 token 映射成一个固定长度的稠密向量:
| Token | 词向量(示例 4 维) |
|---|---|
| "水" | [0.2, -0.1, 0.3, 0.0] |
| "是" | [0.0, 0.5, -0.2, 0.1] |
| "有毒" | [0.9, -0.3, 0.4, 0.2] |
| "的" | [0.1, 0.0, 0.0, 0.1] |
步骤三:合并词向量
到这里出现了第一个岔路口。FNN 要求固定维度的输入,所以必须把变长的向量列表压成一个向量:
方案 A:平均(Mean Pooling)
方案 B:拼接(Concatenation)
n × d,随句子长度线性增长。
FNN 的第一层权重维度就固化了,面对不同长度的句子处理效率低下,
而且仍然「把句子视作一个整体」,无法建模真正的「谁先谁后」。
03RNN:解决了词序,引入了串行
Recurrent Neural Network — 用「时间步」换取顺序建模能力
3.1 RNN 解决了什么
RNN 相对 FNN 的进步,恰好补上了上一节的两条缺陷:
| RNN 的能力 | 如何解决 FNN 的问题 |
|---|---|
| 建模词序 | 按时间步(token 顺序)逐个处理输入,顺序天然被编码进计算过程 |
| 建模上下文依赖 | 逐个喂入词语,并通过「记忆」(隐藏状态)在时间步之间传递信息 |
| 支持不定长输入 | 不再需要固定长度的输入格式,句子多长都行 |
Williams, R. J., & Zipser, D. (1989). A learning algorithm for continually running fully recurrent neural networks. Neural Computation, 1(2), 270–280. | Elman, J. L. (1990). Finding structure in time. Cognitive Science, 14(2), 179–211.
3.2 符号约定与核心公式
| 符号 | 含义 |
|---|---|
| $x_t$ | 第 $t$ 个时间步的输入 |
| $h_t$ | 第 $t$ 个时间步的隐藏状态(也就是「记忆」) |
| $y_t$ | 第 $t$ 个时间步的输出(某些任务没有输出) |
| $U,\;V,\;W$ | 权重矩阵 |
关于两个激活函数 g
- $h_t$ 中的 $g$:如 ReLU、sigmoid。作用有二—— ① 引入非线性,增强表达能力;② 限制数值范围,缓解梯度爆炸/消失。
- $y_t$ 中的 $g$:视任务而定。分类任务里可能是 softmax, 把输出转成概率分布。
3.3 致命缺陷:无法并行
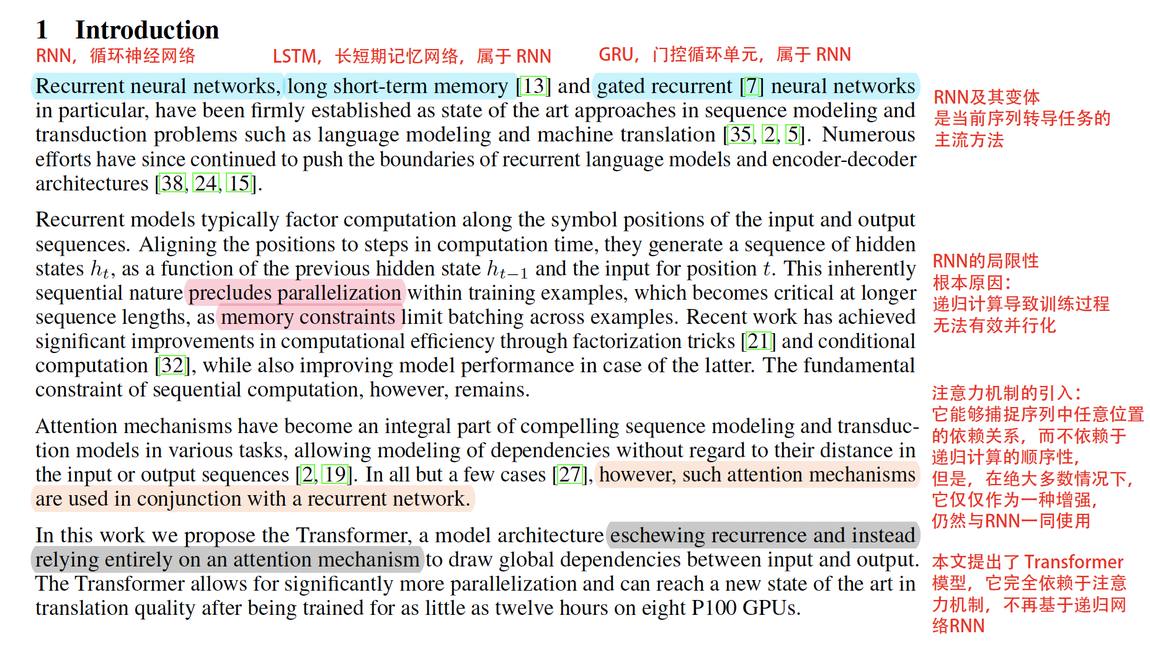
这就是论文中所说的 "inherently sequential nature precludes parallelization within training examples"——本质上的顺序特性,阻止了训练样例内部的并行化。 序列越长,这个代价越致命:
- 算得慢:GPU 擅长并行矩阵运算,但 RNN 给的是一条链,只能逐步推进,硬件利用率极低。
- 不能做大 batch:论文明确指出,长序列下内存约束限制了跨样例的批处理规模。
- 梯度消失:反向传播时梯度要沿这条链连乘 $U$ 走 $n$ 步, 连乘 n 次的结果会指数级衰减或放大。LSTM / GRU 就是为了缓解这个问题而发明的。
04编码器-解码器:上下文向量的信息瓶颈
Encoder–Decoder — 输入输出不等长怎么解
4.1 结构要解决的问题
序列转导任务的一个硬性要求是:输入和输出长度通常不相等,且事先不知道输出有多长。 FNN 和裸 RNN 都处理不了这件事。Sutskever 等人提出的编码器-解码器结构专门解决它。
Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to sequence learning with neural networks. Advances in Neural Information Processing Systems, 27.
映射为连续表示 $z=(z_1,\dots,z_n)$
给定 $z$,解码器一次一个元素地生成输出序列 $(y_1,\dots,y_m)$
每一步是自回归的(auto-regressive):生成下一个时,把已生成的符号再喂回去
4.2 上下文向量 C
连接编码器与解码器的桥梁,是一个叫 C(context vector,上下文向量)的东西。 它是对整个输入序列的语义编码——一个固定长度的向量,涵盖了整个输入文本的语义信息。
最简单的编码方式就是取编码器最后一个时间步的隐藏状态:
这个设计的代价
此外还有两个次生问题:
- 解码器只在一个时间步(t=0)看到 C,之后就靠自己的隐藏状态往下传, 早期信息同样会被稀释。
- C 是静态的。整个生成过程中,条件向量 C 始终不变, 无法针对当前正在生成的词动态调整关注重点。
05注意力机制:把固定瓶颈换成动态加权
Attention Mechanism — RNN 的第二次赋能
5.1 注意力要解决的两个问题
Bahdanau, D., Cho, K., & Bengio, Y. (2014). Neural machine translation by jointly learning to align and translate. arXiv:1409.0473.
5.2 机制:每一时间步生成一个自己的 C
关键改动是:不再只有一个固定的 C,而是解码器每一步都生成一个新的上下文向量 $C_i$。做法是:对所有编码器隐藏状态 $\{h_1,\dots,h_4\}$ 计算一组权重 $\alpha_1,\dots,\alpha_4$,做加权求和。
例:生成第 1 个词(对应 "I")
模型判断此刻应该重点关注「我爱水课」的哪一部分,算出权重并加权:
注意力主要压在 $h_1$(「我」)上,所以这一轮大概率生成 $I$。
例:生成第 2 个词(对应 "love")
注意力整体右移到 $h_2$(「爱」),权重 0.7 高度集中,于是生成 $love$。
例:生成第 3 个词(对应 "easy")
权重平分在 $h_3$、$h_4$(「水课」这个整体)上。
06研究背景:为什么必须是 Self-Attention
Background — 三条备选路线及其失败原因
第 5 章末尾留下的问题很明确:RNN 的串行计算必须被消除。 在 Transformer 之前,学界有两条并行的尝试路线,视频把它们讲得很清楚。
6.1 路线一:用 CNN 做并行化
"The goal of reducing sequential computation also forms the foundation of the Extended Neural GPU, ByteNet and ConvS2S." —— 三个工作都用卷积作为基本构件, 并行计算所有输入输出位置的隐藏表示。这条路确实解决了并行问题,但栽在了另一件事上。
| 方案 | 并行化程度 | 最大路径长度 | 问题 |
|---|---|---|---|
| RNN(Recurrent) | 完全串行 | O(n) | 训练慢、无法并行 |
| ConvS2S(Convolutional) | 完全并行 | $\mathcal{O}(\sqrt{k}\,n)$ | 长距离依赖难学 |
| ByteNet(膨胀卷积) | 完全并行 | $\mathcal{O}(\log_k n)$ | 仍不如 O(1) |
| Self-Attention | 完全并行 | O(1) | 常数步即连任意两位置 |
数据来源:论文 Table 1(n 为序列长度,d 为表示维度,k 为卷积核大小,r 为受限自注意力的邻域大小)
6.2 路线二:Memory Network 用注意力替代递归
End-to-end Memory Network 走的是另一条路:用递归的注意力机制取代序列对齐的递归, 从「记忆」中多轮读取信息,在简单问答和语言建模上表现不错。
但它的递归只是从「按位置递归」变成了「按推理轮次递归」——
6.3 Transformer:第三条路,抛掉 RNN 和 CNN
Transformer 是第一个完全基于自注意力、不使用任何序列对齐的 RNN 或卷积的转导模型。 论文原句:"the Transformer is the first transduction model relying entirely on self-attention to compute representations of its input and output without using sequence-aligned RNNs or convolution."
从 O(n) 降到 O(1) —— 远距离依赖只需一次注意力操作
代价是有效分辨率下降(加权平均会模糊细节),
用多头注意力来对冲这个代价
| 能力 | FNN | RNN | Enc-Dec | +注意力 | Transformer |
|---|---|---|---|---|---|
| 建模词序 | ✗ | ✓ | ✓ | ✓ | ✓ |
| 建模上下文依赖 | ✗ | ✓ | ✓ | ✓ | ✓ |
| 支持不定长输入 | ✗ | ✓ | ✓ | ✓ | ✓ |
| 支持输入输出不等长 | ✗ | ✗ | ✓ | ✓ | ✓ |
| 解决长序列「遗忘」 | ✗ | ✗ | ✗ | ✓ | ✓ |
| 区分时间步重要性 | ✗ | ✗ | ✗ | ✓ | ✓ |
| 解决串行化计算 | ✗ | ✗ | ✗ | ✗ | ✓ |
07Transformer 架构详解
Model Architecture — 全片最核心的 33 分钟
本章逐层拆解 Transformer。对应论文第 3 节(架构)、第 4 节(为何用自注意力)、第 5 节(训练)、第 6 节(结果)。
7.1 整体架构
Transformer 遵循编码器-解码器的整体骨架,但核心机制完全不同: 多层堆叠的自注意力机制 + 逐点全连接层, 而非卷积或递归。
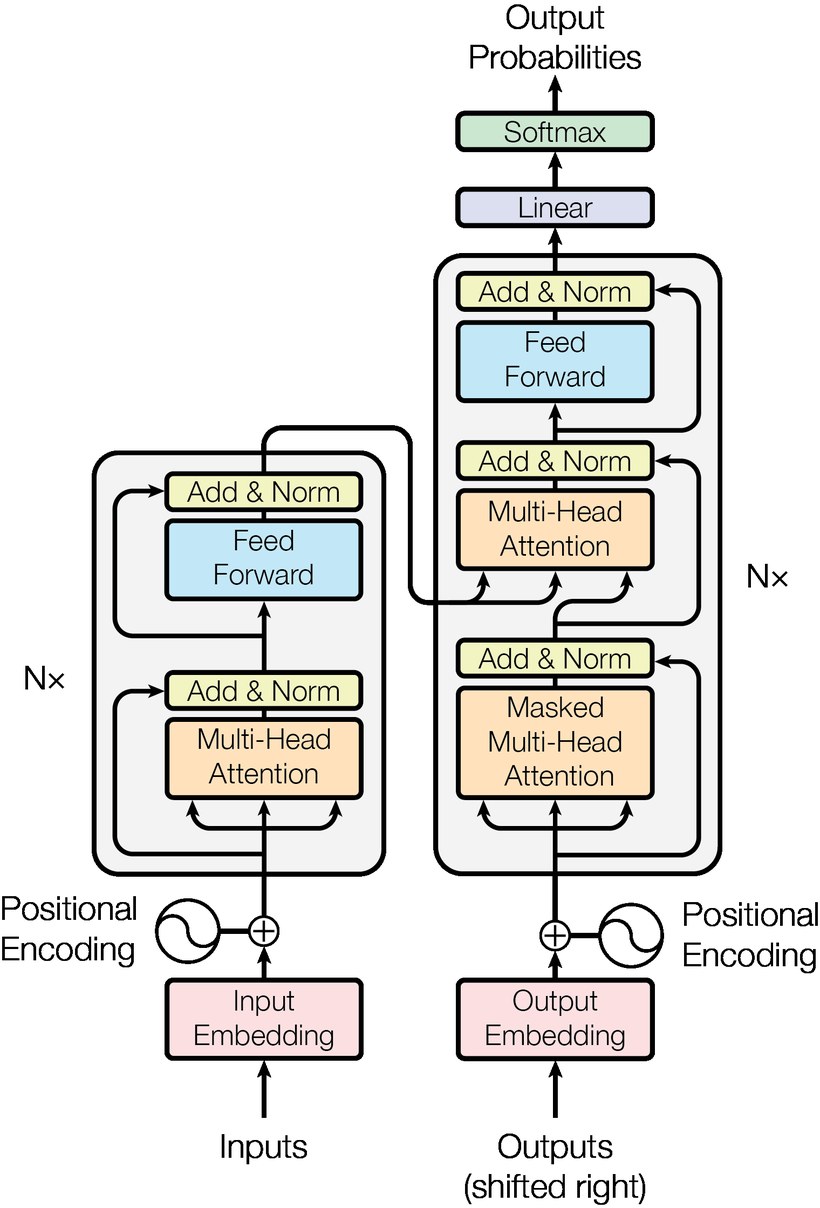
② 每一层内部都是 Add & Norm(残差 + 层归一化) 包裹一个子层。
③ 编码器有两个子层,解码器有三个(多出的那个是跨接编码器的多头注意力)。
7.2 编码器 / 解码器堆叠
编码器(Encoder)——N = 6 层
每层包含两个子层,顺序固定:
- 多头自注意力机制(Multi-Head Self-Attention)
- 逐位置全连接前馈网络(Position-wise FFN)
每个子层外面都套一层残差连接,残差之后再做层归一化。
论文把子层函数记作 Sublayer(x),整体输出就是:
解码器(Decoder)——N = 6 层
结构与编码器基本一致,但有两处关键改动:
7.3 缩放点积注意力(Scaled Dot-Product Attention)
7.3.1 注意力函数的抽象定义
论文先把注意力抽象成一个通用函数(论文 §3.2):
(query、key、value、输出全都是向量)
输出 = 所有 value 的加权求和
每个 value 的权重 = query 与对应 key 的相容性函数
这个定义是全文最精炼的抽象。翻译成一句话:我拿着 query 去和每个 key 比对打分, 分数决定我从每个 value 里取多少信息,然后取加权平均。
7.3.2 计算公式与逐步推导
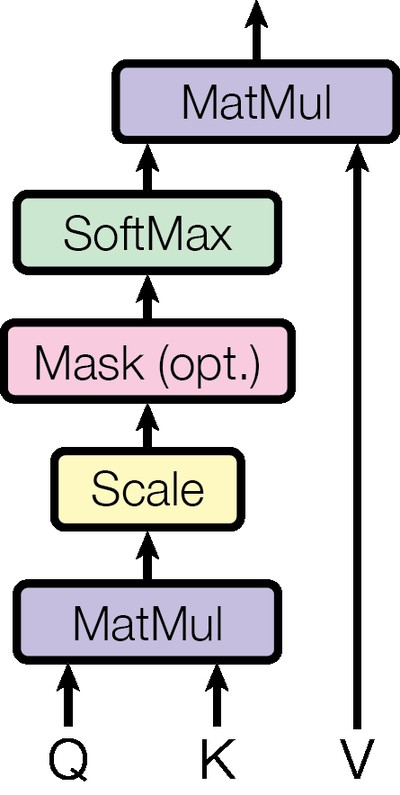
输入:维度为 $d_k$ 的 queries 和 keys,维度为 $d_v$ 的 values。步骤如下:
- 计算 query 与所有 key 的点积 → 得到相似度矩阵 $Q K^{\mathsf{T}}$
- 每个元素除以 $\sqrt{d_k}$ → 缩放
- 套上 softmax → 得到作用在 value 上的权重
- 用权重对 value 做加权平均 → 乘 V
实际实现中,一组 queries、keys、values 分别打包成矩阵 Q、K、V,一次矩阵运算算完所有位置:
7.3.3 为什么用点积?
论文比较了两种最常用的注意力函数:
| 函数 | 相容性怎么算 | 特点 |
|---|---|---|
| 加性注意力 Additive | 用一个单隐藏层的前馈网络 | 理论复杂度与点积相当,但慢 |
| 点积注意力 Dot-product | 直接算 q·k | 快、空间效率高,可调用高度优化的矩阵乘法 |
论文明确选择点积:"dot-product attention is much faster and more space-efficient in practice, since it can be implemented using highly optimized matrix multiplication code." 缩放点积注意力与朴素点积注意力唯一的区别就是那个 $1/\sqrt{d_k}$ 因子。
7.3.4 为什么必须除以 $\sqrt{d_k}$?
这是视频重点强调的一处推导。论文的假设和推导链是这样的:
则点积 $q\cdot k=\sum_{i=1}^{d_k}q_i k_i$
期望 $0$
方差 $d_k$
于是标准差为 $\sqrt{d_k}$。当 $d_k$ 较大(比如 64 甚至 512)时:
- 点积的量级会变得很大,取值范围被推离 0 附近。
- softmax 的输入一旦进入饱和区(两极分化),梯度会极小。
- 论文原话:"pushing the softmax function into regions where it has extremely small gradients"。
7.4 多头注意力(Multi-Head Attention)
7.4.1 动机:单个头会被「平均」抹平
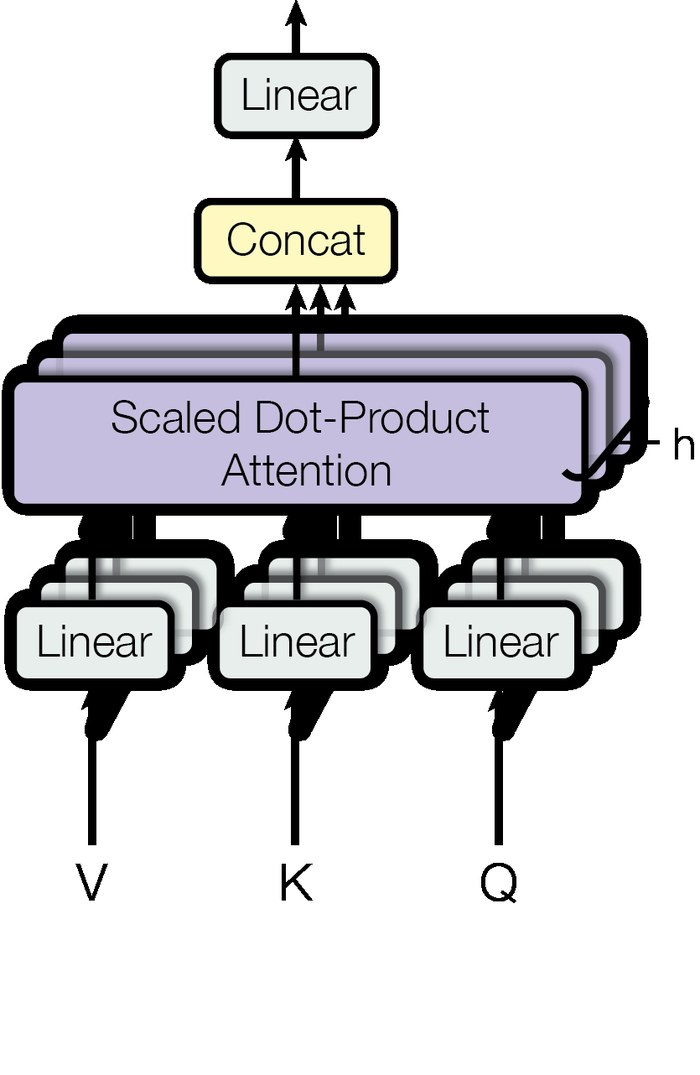
论文的做法是:不用 $d_{model}$ 维的 key/value/query 做一次注意力, 而是把它线性投影 h 次,得到 h 组不同维度的 Q、K、V, 在这 h 组上并行做注意力,最后把结果拼接起来再投影一次。
| 投影矩阵 | 形状 | 说明 |
|---|---|---|
| $W_i^{Q},\;W_i^{K}$ | $\mathbb{R}^{d_{model}\times d_k}$ | 每个头各自的 Q、K 投影 |
| $W_i^{V}$ | $\mathbb{R}^{d_{model}\times d_v}$ | 每个头各自的 V 投影 |
| $W^{O}$ | $\mathbb{R}^{h\cdot d_v\times d_{model}}$ | 拼接后的最终输出投影 |
7.4.2 论文的取值:h = 8
每个头:$d_k=d_v=d_{model}/h=512/8=\mathbf{64}$
因为每个头的维度被压小了,所以总计算量与全维度的单头注意力相当——多头是"免费"的表达力提升
7.4.3 多头究竟带来了什么?
翻译过来:单头注意力的"加权平均"会抹平差异—— 你只能得到一种关注模式。多头则允许模型同时从多个不同的表示子空间、 针对不同位置去联合提取信息。直观地说,一个头可以关注句法依存,另一个头关注共指消解, 第三个头关注相邻词的局部搭配。第 8 章的注意力可视化会直接看到这种分工。
实验数据也支持这一点(论文 Table 3 A 行,控制总计算量不变只改头数):
| 头数 h | $d_k=d_v$ | PPL (dev) | BLEU | 结论 |
|---|---|---|---|---|
| 1 | 512 | 5.29 | 24.9 | 最差,比最佳设置低 0.9 BLEU |
| 4 | 128 | 5.00 | 25.5 | |
| 8 | 64 | 4.92 | 25.8 | 最佳 |
| 16 | 32 | 5.01 | 25.4 | 头数过多反而下降 |
数据来源:论文 Table 3 (A) 行,newstest2013 英德开发集。base 模型为 8 头 / 512 维
7.5 注意力的三种用法
Transformer 里一共用了三种多头注意力,区别只在于 Q / K / V 各自从哪来:
| 类型 | Query 来自 | Key / Value 来自 | 效果 |
|---|---|---|---|
| ① Encoder-Decoder Attention 跨接注意力 |
解码器上一层的输出 | 编码器的输出 | 解码器每个位置可关注输入序列的所有位置。相当于把第 5 章的注意力机制接进架构里 |
| ② 自注意力(编码器内) | 编码器上一层的输出 | 编码器上一层(同一个来源) | 编码器每个位置可关注编码器上一层的所有位置,无掩码 |
| ③ 自注意力(解码器内) 带掩码 |
解码器上一层 | 解码器上一层(同一个来源) | 只能关注当前位置及之前的位置。通过在 softmax 前把非法值置为 $-\infty$ 实现,保持自回归 |
7.6 前馈网络、嵌入与 Softmax
逐位置前馈网络(Position-wise FFN)
除注意力子层外,每一层还包含一个全连接前馈网络,它对每个位置独立且相同地作用。 本质是两次线性变换,中间夹一个 ReLU:
② 论文给了个形象说法:这相当于两次 kernel size = 1 的卷积。
③ 维度:输入输出均为 $d_{model}=512$,中间层维度 $d_{ff}=2048$ (先升维 4 倍再降回来,让每个位置有足够的"思考空间")。
嵌入与 Softmax
- 嵌入层:把输入 token 和输出 token 转成 $d_{model}$ 维向量(用学到的嵌入)。
- 线性 + Softmax:把解码器输出转成下一个 token 的预测概率。
- 权重共享:两个嵌入层和 softmax 前的线性变换共用同一个权重矩阵。
- 一个技巧:在嵌入层里,把这些权重乘以 $\sqrt{d_{model}}$。
7.7 位置编码:Transformer 凭什么知道顺序
正因为丢掉了递归和卷积,Transformer 天生对顺序完全不敏感—— 自注意力里的 $Q K^{\mathsf{T}}$ 是对称的,打乱词序后得到的注意力权重只是相应地重排。 所以必须显式注入位置信息。
做法:正弦-余弦函数
位置编码加在编码器和解码器堆叠的底部,与输入嵌入相加。 它的维度与嵌入相同($d_{model}=512$),这样才能直接相加。
也就是说,位置编码的每一个维度都对应一条正弦曲线, 其波长构成从 2π 到 10000·2π 的几何级数。
为什么选正余弦?两个理由
- 便于学习相对位置:论文的假设是——对任意固定偏移 k, $\mathrm{PE}_{pos+k}$ 都能表示成 $\mathrm{PE}_{pos}$ 的线性函数。 (这来自三角函数的加法公式 sin(a+b) = sin a cos b + cos a sin b。) 也就是说模型学一个"偏移 k"的线性变换,就能表达任意相对距离。
- 可外推到更长的序列:选正弦版而非学出来的位置嵌入, 是因为它可能允许模型外推到训练时未见过的更长序列。
论文也做了对照实验(Table 3 E 行):把正弦位置编码换成学出来的位置嵌入, 结果是 PPL 4.92 → 4.92,BLEU 25.8 → 25.7,几乎完全一致。 但正弦版在长度外推上更有潜力,所以最终选了它。
7.8 为什么是自注意力:三项指标对比
论文 §4 用三个考量来论证自注意力的选择,这也是视频最后总结的骨架:
- 每层的总计算复杂度
- 可并行化的计算量(用最少串行操作数衡量)
- 网络内部长距离依赖的路径长度
第 3 条是重点:信号在网络里前向和反向要走的路径越短,学长距离依赖就越容易。
| 层类型 | 每层复杂度 | 最少串行操作数 | 最大路径长度 |
|---|---|---|---|
| Self-Attention | O(n²·d) | O(1) | O(1) |
| Recurrent(RNN) | O(n·d²) | O(n) | O(n) |
| Convolutional | O(k·n·d²) | O(1) | $\mathcal{O}(\log_k n)$ |
| Self-Attention(受限,邻域 r) | O(r·n·d) | O(1) | O(n/r) |
论文 Table 1。n = 序列长度,d = 表示维度,k = 卷积核大小,r = 受限自注意力的邻域大小
② 当 n < d 时,自注意力比循环层更快。这在句子表示这类场景中通常都成立 (word-piece / BPE 表示的 n 一般远小于 d)。
③ 要处理超长序列:可以限制自注意力只看中心邻域 r, 复杂度降到 O(r·n·d),但最大路径长度会升到 O(n/r)。论文把这个留给未来工作。
④ 可分离卷积也不划算:即使 k = n,可分离卷积的复杂度 O(k·n·d + n·d²) 也恰好等于一个自注意力层加一个逐点前馈层——正是本模型采用的组合。
论文还提到一个额外好处:自注意力可以产出更可解释的模型(见第 8 章)。
7.9 训练与实验结果
训练配置
| 项目 | 设置 |
|---|---|
| 数据 | WMT 2014 英德(约 450 万句对,BPE 共享词表约 37000 token);英法(3600 万句,32000 word-piece 词表) |
| 批处理 | 按近似序列长度分批,每批约 25000 源 token + 25000 目标 token |
| 硬件 | 单机 8 × NVIDIA P100 |
| 优化器 | Adam,$\beta_1=0.9$,$\beta_2=0.98$,$\varepsilon=10^{-9}$ |
| 学习率调度 | $\mathrm{lrate}=d_{model}^{-0.5}\cdot\min(\mathrm{step\_num}^{-0.5},\ \mathrm{step\_num}\cdot\mathrm{warmup\_steps}^{-1.5})$,warmup_steps = 4000 |
| 正则化 | 残差 dropout($P_{drop}=0.1$)+ 标签平滑($\varepsilon_{ls}=0.1$) |
| 训练时长 | base:10 万步 / 12 小时(每步 0.4s);big:30 万步 / 3.5 天(每步 1.0s) |
学习率调度公式 (3) 的含义:前 warmup_steps 步线性升温,之后按步数的平方根倒数衰减。 这是 Noam Schedule,如今几乎成了 Transformer 训练的标准配置。
翻译任务结果(Table 2)
| 模型 | EN-DE BLEU | EN-FR BLEU | EN-DE 训练成本 |
|---|---|---|---|
| ConvS2S Ensemble | 26.36 | 41.29 | $7.7{\times}10^{19}$ |
| GNMT + RL Ensemble | 26.30 | 41.16 | $1.8{\times}10^{20}$ |
| Transformer (base) | 27.3 | 38.1 | $3.3{\times}10^{18}$ |
| Transformer (big) | 28.4 | 41.8 | $2.3{\times}10^{19}$ |
② 成本更低:英德任务上训练成本只有 $2.3{\times}10^{19}$ FLOPs, 而 GNMT 集成是 $1.1{\times}10^{21}$——差了近 50 倍。 质量与成本同时取胜,这才是「革命性突破」的含义。
泛化性验证:英语成分句法分析(Table 4)
为了证明 Transformer 不是只会翻译,作者把它用在了结构约束极强的英语成分句法分析上。 4 层、$d_{model}=1024$,在 WSJ(4 万句)上训练:
| 解析器 | 训练数据 | WSJ 23 F1 |
|---|---|---|
| Dyer et al. (2016) 神经递归文法 | WSJ only, 判别式 | 91.7 |
| Transformer (4 层) | WSJ only, 判别式 | 91.3 |
| Dyer et al. (2016) | 半监督 | 93.3 |
| Transformer (4 层) | 半监督 | 92.7 |
论文的评价是:"despite the lack of task-specific tuning our model performs surprisingly well" ——在几乎没有针对该任务调参的情况下,半监督设置下超过了除神经递归文法外的所有已报道模型, 而且在只有 4 万句的小数据场景下也超过了 Berkeley Parser 这类传统方法。
08注意力可视化:模型到底在想什么
Attention Visualizations — 自注意力的可解释性红利
这是论文附录最有说服力的部分,也是「自注意力更可解释」这句话的具体兑现。 下图中,每一行是一个查询位置,每一列是一个被关注的键位置, 颜色越深表示权重越大,不同颜色代表不同的注意力头。
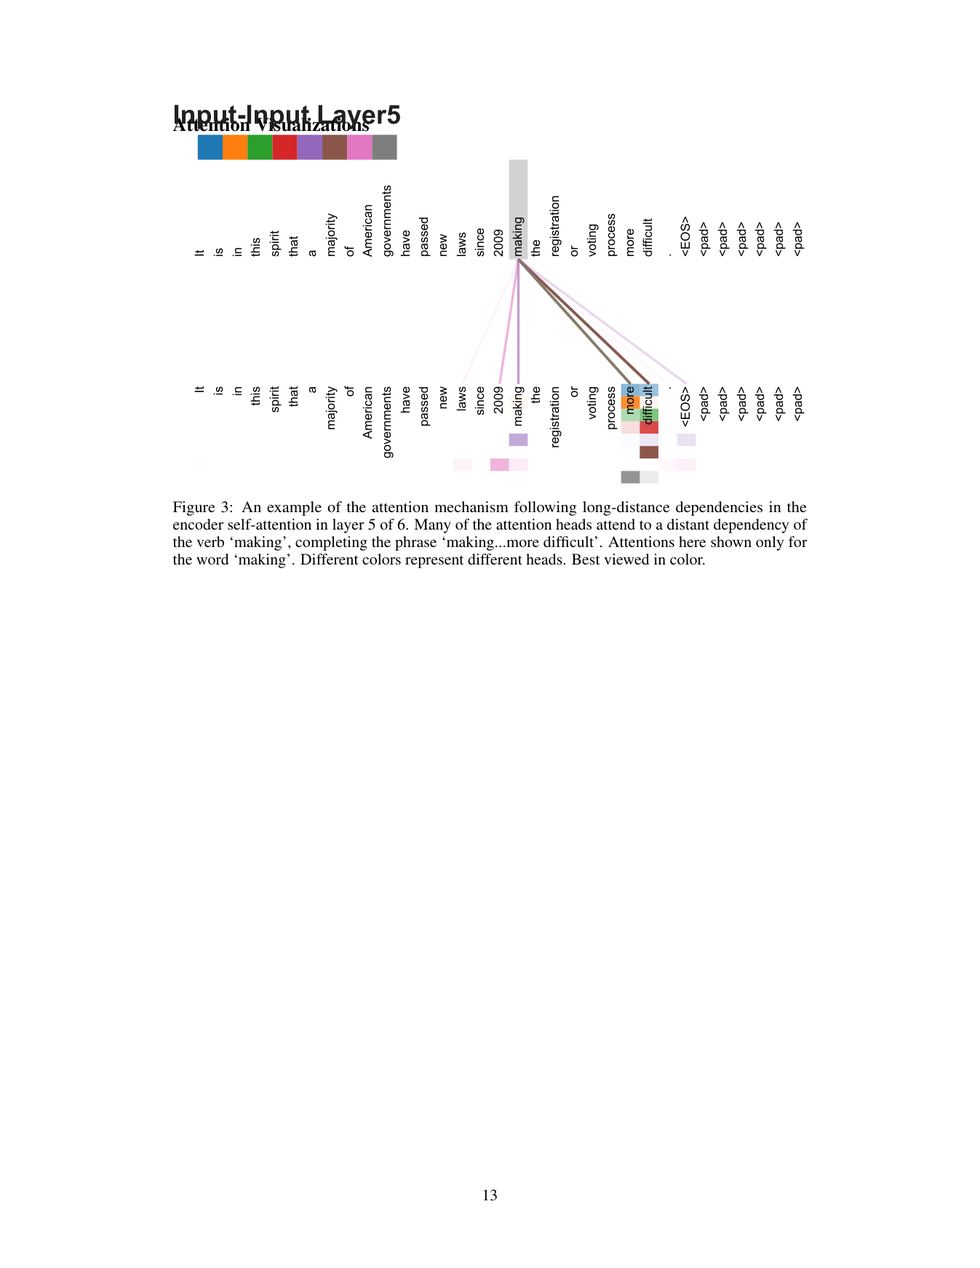
It 和句尾的 . 两端的词,
几乎被所有注意力头一致地指向中间的 "making"。
这说明模型自发地学到了跨越 10 个词的依存关系——
正是第 6 章那张 Table 1 里「最大路径长度 O(1)」的实证体现。
如果是 RNN,这需要 10 步递归传递。
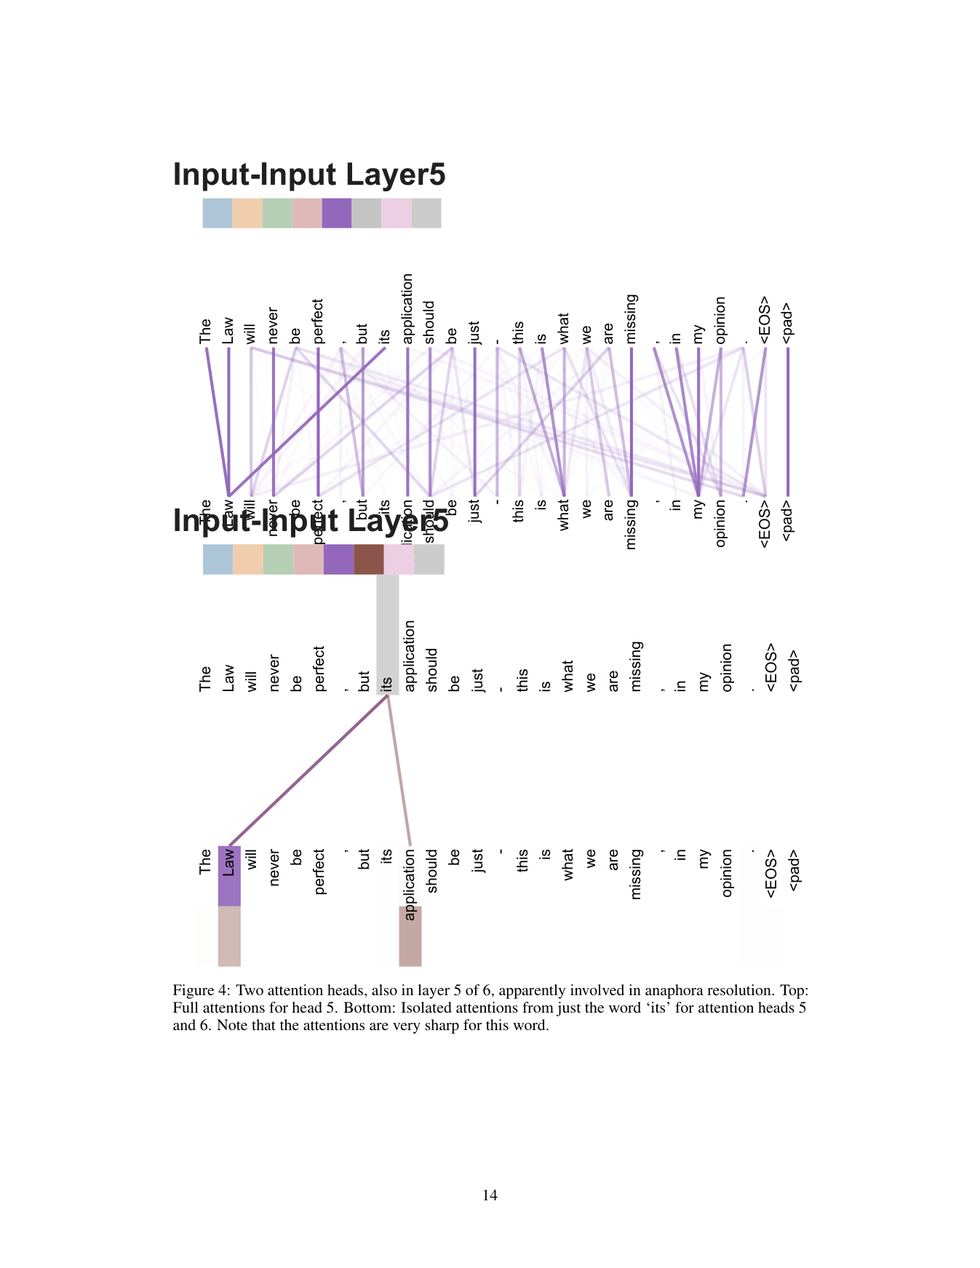
its 这个词的注意力。
注意 its 的注意力非常尖锐(sharp)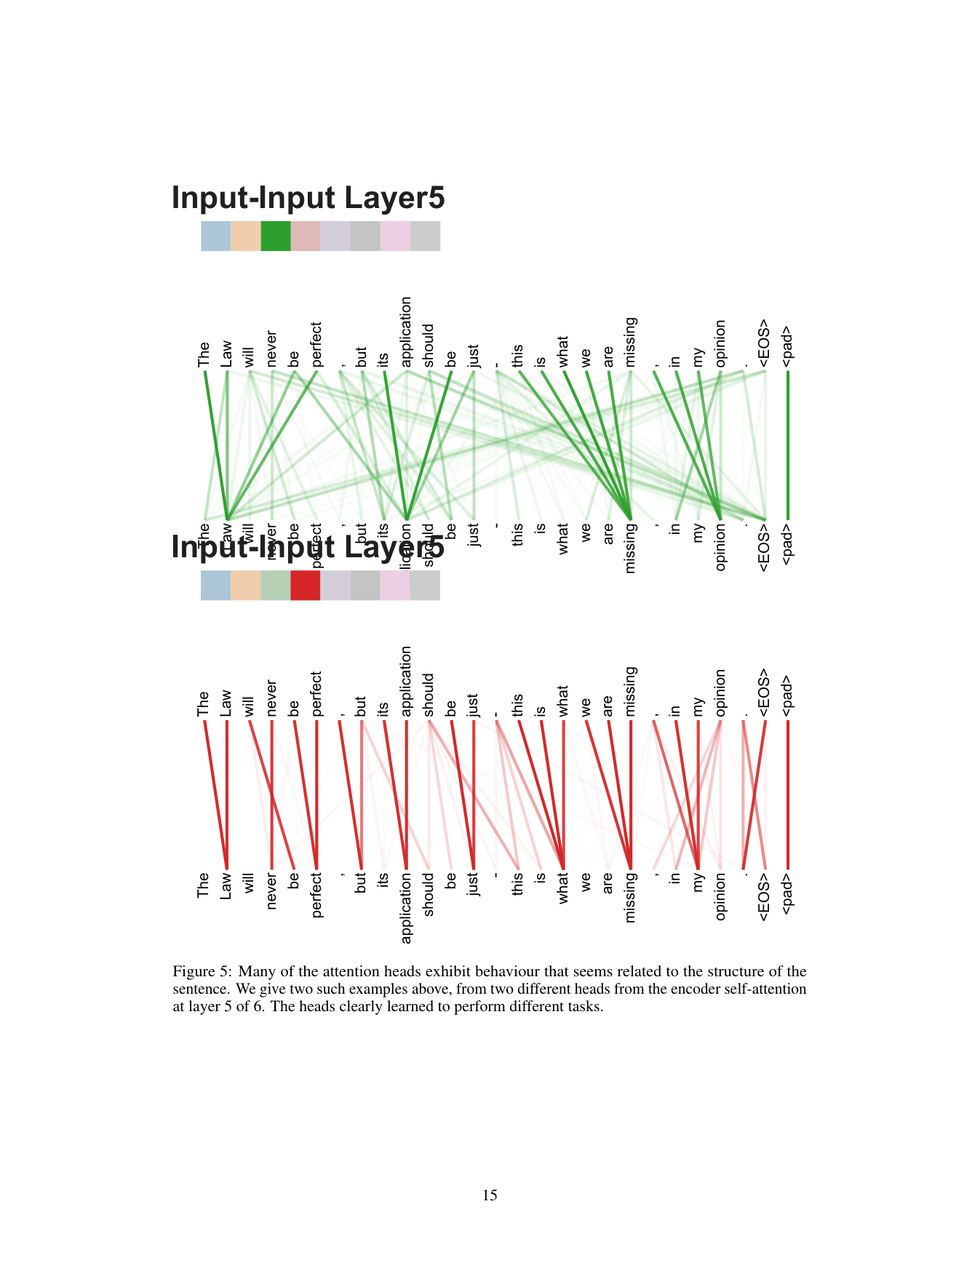
8.1 这三张图证明了什么
| 观察 | 对架构设计的印证 |
|---|---|
| 不同头分工不同(Fig 5) | 多头注意力确实带来了多样化的表示子空间,而不是同一个模式的重复 |
| 能捕获远距离依存(Fig 3) | O(1) 路径长度的理论优势在真实模型中确实兑现 |
| 能学到共指消解(Fig 4) | 模型自发学到了句法与语义结构,而非仅仅是表面共现 |
| 注意力尖锐且可分辨(Fig 4) | 可解释性可以直接从权重矩阵读出,不需要额外探针 |
09精简速查手册
Cheat Sheet — 一页带走
① 全部核心公式
② 关键超参数
| 参数 | base | big | 说明 |
|---|---|---|---|
| N(层数,编/解码器各) | 6 | 6 | 堆叠相同结构层 |
| $d_{model}$ | 512 | 1024 | 所有子层统一输出此维度 |
| $d_{ff}$ | 2048 | 4096 | FFN 中间层,$=4\times d_{model}$ |
| h(头数) | 8 | 16 | base 下 8 头为最佳 |
| $d_k=d_v$ | 64 | 64 | $=d_{model}/h$ |
| $P_{drop}$ | 0.1 | 0.3 | EN-FR big 用 0.1 |
| $\varepsilon_{ls}$(标签平滑) | 0.1 | 0.1 | 损困惑度但涨 BLEU |
| warmup_steps | 4000 | 4000 | Noam Schedule |
| 训练步数 | 100K | 300K | 12 小时 / 3.5 天 @ 8×P100 |
| 参数量 | 65M | 213M |
③ 四种注意力的辨析
| 类型 | Q 来自 | K/V 来自 | 是否掩码 | 在 Transformer 中 |
|---|---|---|---|---|
| 自注意力(编码器) | 编码器上一层 | 编码器上一层 | 否 | ✓ 子层 1 |
| 自注意力(解码器) | 解码器上一层 | 解码器上一层 | 是($-\infty$) | ✓ 子层 1 |
| 编解码器注意力 | 解码器上一层 | 编码器输出 | 否 | ✓ 子层 2 |
| RNN 注意力(第 5 章) | 解码器隐藏状态 | 编码器隐藏状态 | 否 | 架构仍是 RNN |
④ 复杂度速查
| 层类型 | 每层复杂度 | 串行操作数 | 最大路径 |
|---|---|---|---|
| Self-Attention | O(n²·d) | O(1) | O(1) |
| Recurrent | O(n·d²) | O(n) | O(n) |
| Convolutional | O(k·n·d²) | O(1) | $\mathcal{O}(\log_k n)$ |
| Self-Attn(受限 r) | O(r·n·d) | O(1) | O(n/r) |
当 n < d 时,自注意力比循环层更快。
⑤ 四条"为什么"一句话版
| 问题 | 答案 |
|---|---|
| 为什么不用 FNN? | 无法建模词序,且要求定长输入——结构性问题 |
| 为什么不用 RNN? | $h_t$ 依赖 $h_{t-1}$,无法并行,长序列还梯度消失 |
| 为什么不用单纯的编解码器? | 整个输入压成一个固定长度静态向量 C,有损且无法动态关注 |
| 为什么不用 RNN+注意力? | 注意力只是补丁,编解码器仍是 RNN,串行根还在 |
| 为什么要除 $\sqrt{d_k}$? | 点积方差是 $d_k$,不缩放会把 softmax 推进梯度极小的饱和区 |
| 为什么要多头? | 单头的加权平均会抹平差异;多头从多个子空间并行提取 |
| 为什么要位置编码? | 没有递归和卷积,模型对顺序天然不敏感 |
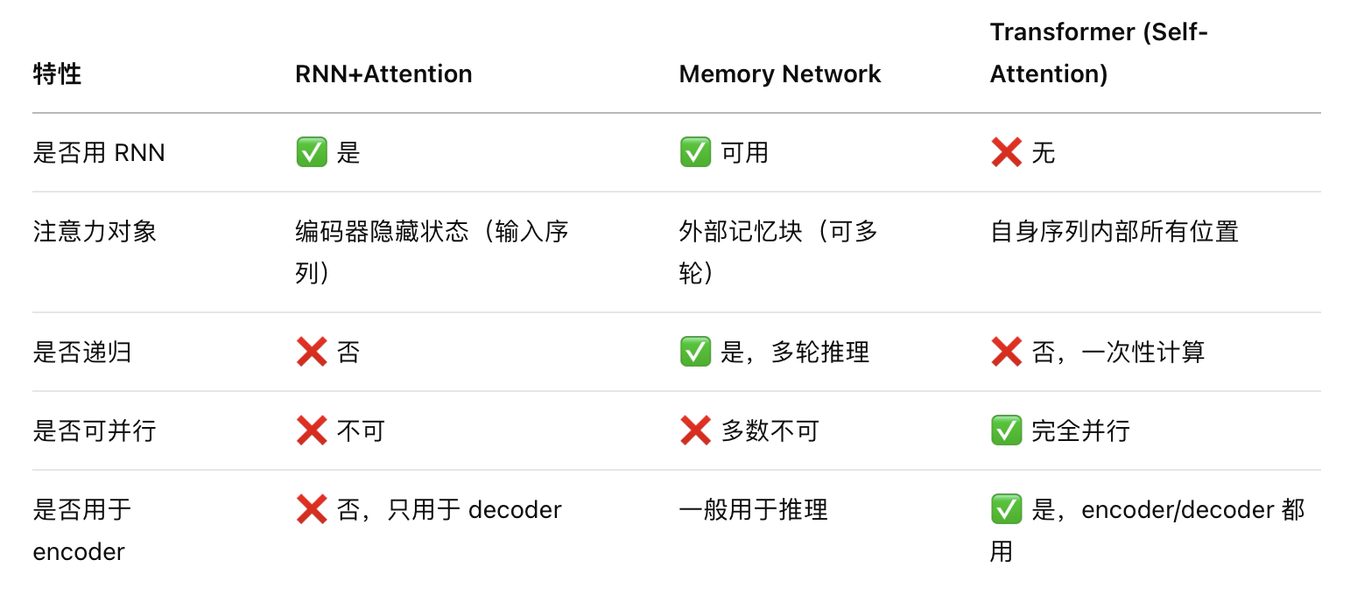
⑥ 三种注意力范式一句话对比
| RNN + Attention | Memory Network | Transformer | |
|---|---|---|---|
| 注意力对象 | 编码器隐藏状态(输入序列) | 外部记忆块(可多轮) | 自身序列内部所有位置 |
| 是否递归 | 否(但 RNN 自身递归) | 是,多轮推理 | 否,一次性计算 |
| 可并行 | 不可 | 多数不可 | 完全并行 |
| 用在哪 | 只用于 decoder | 一般用于推理 | encoder / decoder 都用 |
一句话总结:RNN 引入注意力是为了弥补信息瓶颈,但仍是顺序处理; Memory Network 把注意力用在记忆检索上,强调推理,但多轮递归并不高效; Transformer 的自注意力是「全局互相关注」,完全摆脱序列结构、支持并行, 是最底层的范式改变。